
Combien de temps vos équipes ADV consacrent-elles encore à chercher l’équivalent interne d’une référence client ? Pour un grossiste ou un distributeur, une commande peut mentionner un code propre à l’acheteur, une ancienne désignation ou une description en langage courant. La saisie ne consiste alors plus à recopier une ligne, mais à interpréter une demande avant de retrouver le bon article. Pour structurer cette étape, notre approche des références clients dans la gestion des commandes s’appuie sur le rapprochement entre les informations reçues et le référentiel article.
Ce décalage explique pourquoi l’automatisation commandes B2B ne se résume pas à lire un PDF ou un e-mail. L’OCR peut extraire une suite de caractères, mais il ne sait pas nécessairement si « RED-APPLE-500 » correspond à un article actif, à une ancienne référence ou à un produit différent. La valeur vient donc de la capacité à comprendre le contexte client, à vérifier les données et à transmettre une commande fiable dans l’ERP.
Pourquoi chaque client parle une langue produit différente
Un même article peut porter plusieurs identités commerciales. Votre catalogue utilise par exemple « GP-374-L », tandis qu’un client le désigne par « gant chimique taille L », « protection mains EN 374 » ou par son propre code achat. Ces variantes ne sont pas forcément des erreurs. Elles reflètent les habitudes de chaque entreprise, ses anciens catalogues, ses outils d’achat et parfois les références d’un fabricant en amont.
Le problème devient plus sensible lorsque les commandes comportent plusieurs lignes, des conditionnements différents ou des références croisées. Une ligne telle que « 5 cartons de vis inox 5 x 40 » doit être rapprochée d’un article précis, mais aussi d’une unité de vente. Le système doit déterminer si le client demande cinq pièces, cinq boîtes ou cinq cartons contenant chacun plusieurs unités.
En France, les entreprises disposent déjà de nombreux outils de gestion, mais la qualité de la circulation des données reste hétérogène. Selon les données de l’Insee, publiées en 2024 à partir de données 2023, près de la moitié des entreprises françaises utilisaient un progiciel de gestion intégré. Cela ne signifie pas que les informations entrantes sont automatiquement compatibles avec le référentiel de l’ERP.
La référence interne du client doit donc être considérée comme une donnée métier à part entière. Elle ne doit pas rester dans un fichier Excel connu d’une seule personne, ni dans la mémoire d’un opérateur expérimenté. Lorsqu’elle est structurée et rattachée à un client, elle devient exploitable par un moteur de correspondance.
Pourquoi ce décalage bloque la saisie automatisée
Imaginez une commande reçue à 16 heures, avec un PDF comportant dix lignes et des codes qui n’existent pas dans votre base article. Un outil limité à la reconnaissance de caractères peut extraire les références, mais il ne saura pas quoi en faire si aucune correspondance exacte n’est trouvée. L’équipe ADV doit alors ouvrir l’ERP, consulter l’historique, rechercher une désignation approchante, puis vérifier la quantité et le conditionnement.
Cette succession de contrôles explique pourquoi la ressaisie reste fréquente. Chaque ligne peut nécessiter une décision différente. Une référence peut être connue pour un client mais inconnue pour un autre. Un ancien code peut avoir été remplacé. Une faute de frappe peut produire un résultat plausible, mais incorrect. L’automatisation doit donc gérer la confiance, et non seulement l’extraction.
Le risque ne porte pas uniquement sur le temps passé. Une mauvaise correspondance peut provoquer une préparation erronée, une expédition inadaptée, un avoir ou un litige de facturation. La commande peut également être enregistrée avec un mauvais conditionnement, ce qui crée un écart entre la quantité demandée, la quantité livrée et la quantité facturée.
Un cas documenté par Bpifrance sur l’automatisation des bons de commande décrit une entreprise ayant réduit de 80 % le temps de saisie et automatisé 95 % des commandes dans son périmètre de déploiement. Ce résultat ne constitue pas une promesse générale, mais il illustre l’intérêt d’un flux associant extraction, contrôle et transmission vers l’ERP.
Comment l’IA construit la correspondance entre les codes
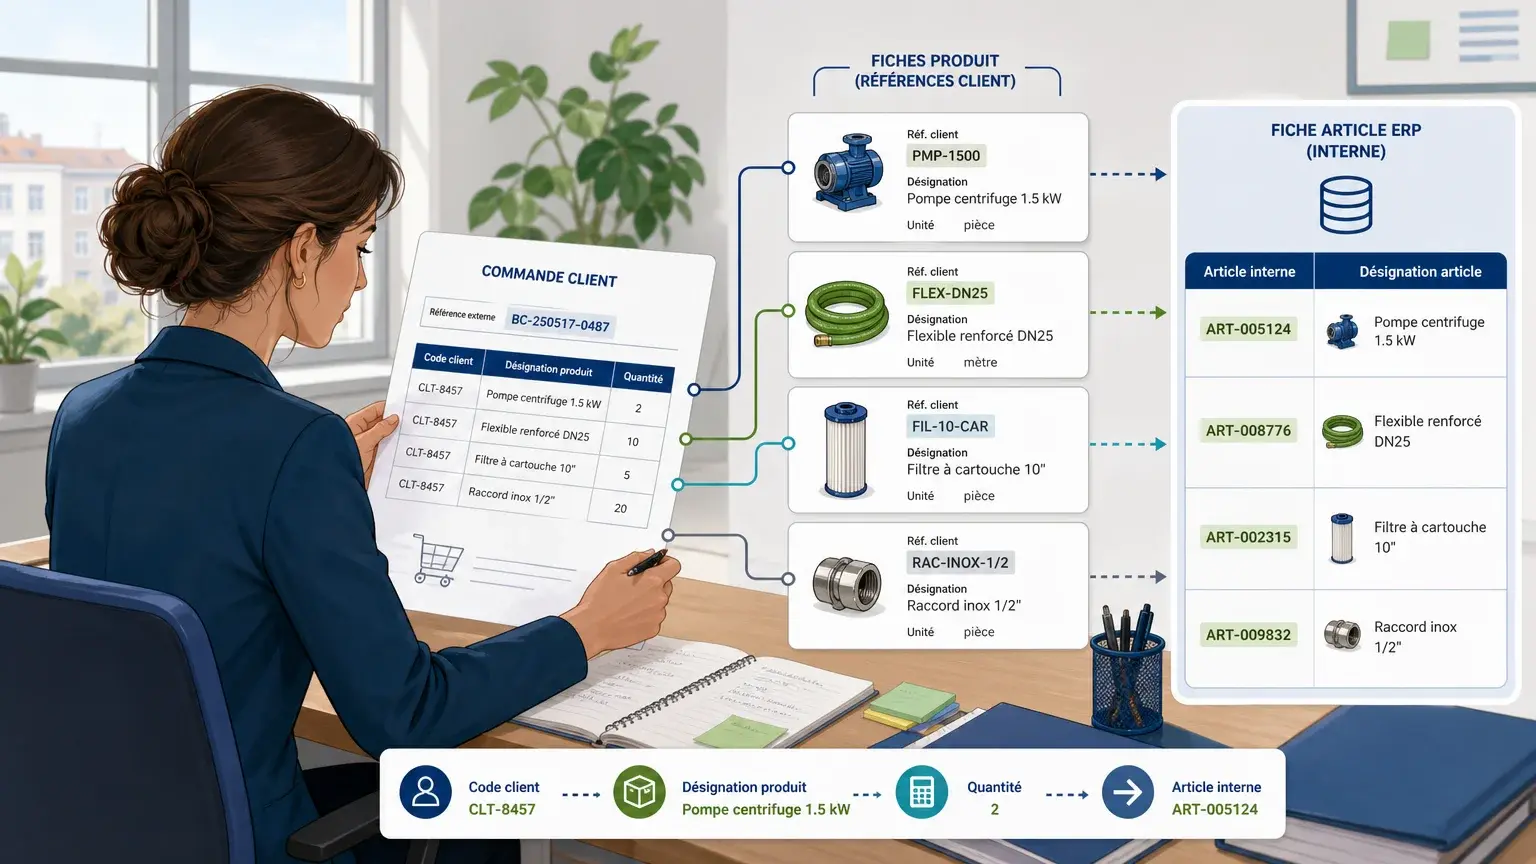
Une correspondance fiable repose généralement sur plusieurs niveaux d’analyse. Le premier est la correspondance exacte, lorsque le code transmis par le client figure déjà dans une table de correspondance client article. Cette table associe le compte client, sa référence, la référence interne, la désignation, l’unité de vente et, si nécessaire, le conditionnement applicable.
Le deuxième niveau exploite les variantes connues. Le moteur peut rapprocher une abréviation, une ancienne désignation ou une référence partiellement saisie avec une fiche article active. Il ne doit toutefois pas se contenter d’une ressemblance visuelle. La catégorie, la matière, la dimension, la norme, la taille et l’historique d’achat doivent concorder avant de proposer une correspondance.
Le troisième niveau intervient lorsque la référence est absente. Le système analyse alors le texte libre de l’e-mail ou de la pièce jointe. Il identifie les attributs utiles, puis recherche l’article correspondant dans le catalogue. Dans ce cas, l’IA ne remplace pas le référentiel produit. Elle l’interroge et l’enrichit avec les validations réalisées par les équipes.
L’apprentissage historique joue un rôle déterminant. Si un client commande régulièrement « RED-APPLE-500 » et que l’ADV valide toujours le rattachement à « PRP-500 », cette association peut être réutilisée lors des commandes suivantes. L’historique ne doit pas être interprété comme une vérité absolue, mais comme un contexte qui augmente la pertinence de la proposition.
Avec VistaFlow, nous combinons l’extraction du corps de l’e-mail et des pièces jointes avec la reconnaissance des références, des quantités et des conditionnements. Notre méthode d’automatisation des commandes conserve une étape de contrôle afin que l’IA accélère les rapprochements sans valider silencieusement une ligne incertaine.
De la correspondance validée à la fiche ERP
Une bonne correspondance n’a de valeur que si elle aboutit au bon enregistrement dans l’ERP. Le flux doit donc rattacher la ligne reconnue à la fiche article interne, récupérer les règles de prix applicables, contrôler l’unité de vente et transmettre les données dans le format attendu par le système de gestion.
Cette étape nécessite une intégration maîtrisée. Selon l’architecture en place, les échanges peuvent passer par une API sécurisée, un accès SFTP ou un connecteur natif. L’objectif est d’éviter une nouvelle ressaisie après la validation de l’IA. Sinon, l’entreprise déplace simplement le travail d’une boîte mail vers un autre écran.
Le contrôle doit également porter sur les données voisines. Une référence correcte avec une quantité incohérente reste une commande à risque. Le système peut comparer la quantité demandée avec les habitudes du client, les seuils de conditionnement et les informations de la fiche article. Une alerte est préférable à une interprétation automatique lorsque plusieurs produits sont plausibles.
La traçabilité complète le dispositif. Il doit être possible de retrouver l’e-mail d’origine, la pièce jointe, la référence détectée, la correspondance proposée, la correction éventuelle et la date d’export dans l’ERP. Cette continuité facilite les recherches en cas de litige et permet d’améliorer progressivement les règles de traitement.
Pour les équipes qui évaluent un logiciel ERP B2B pour les commandes, le critère essentiel n’est donc pas uniquement le nombre de formats documentaires reconnus. Il faut vérifier la capacité à relier les données extraites au référentiel client et article, à gérer les exceptions et à maintenir un historique exploitable.
Quels bénéfices pour les grossistes et distributeurs
Le premier bénéfice est la réduction du temps consacré à la recherche. L’opérateur ne part plus d’une page blanche. Il reçoit une commande structurée, des correspondances proposées et une alerte uniquement lorsque le niveau de confiance est insuffisant. Son rôle évolue vers la validation des cas qui nécessitent réellement son expertise.
Le deuxième bénéfice concerne la fiabilité. Une table de correspondance centralisée réduit les risques liés aux fichiers locaux, aux connaissances individuelles et aux anciennes versions de catalogues. Les corrections deviennent visibles et réutilisables, au lieu de disparaître dans un échange oral ou une annotation temporaire.
Le troisième bénéfice est la diminution des litiges. Une correspondance vérifiée, associée au bon conditionnement et à la bonne quantité, limite les erreurs qui apparaissent au moment de la préparation ou de la facturation. La réduction des litiges dépend évidemment de la qualité du référentiel, des documents reçus et des règles de validation.
Les données disponibles en 2026 invitent toutefois à rester pragmatique. Un baromètre France Supply Chain indique que 66 % des entreprises interrogées ont déjà mis en œuvre des solutions d’automatisation ou de robotisation, tandis que seulement 23 % déclarent des chaînes logistiques majoritairement ou entièrement automatisées. L’automatisation progresse donc, mais elle reste partielle et doit être déployée processus par processus.
VistaFlow indique que ses clients constatent généralement une réduction de 40 % à 80 % du temps global de traitement des commandes. Cette donnée dépend du volume, des formats et de la complexité des flux. Elle doit être vérifiée sur les commandes réelles de l’entreprise, avec des indicateurs tels que le temps par commande, le taux de correction, le nombre d’exceptions et le délai avant création dans l’ERP.
Déployer l’automatisation sans perdre le contrôle
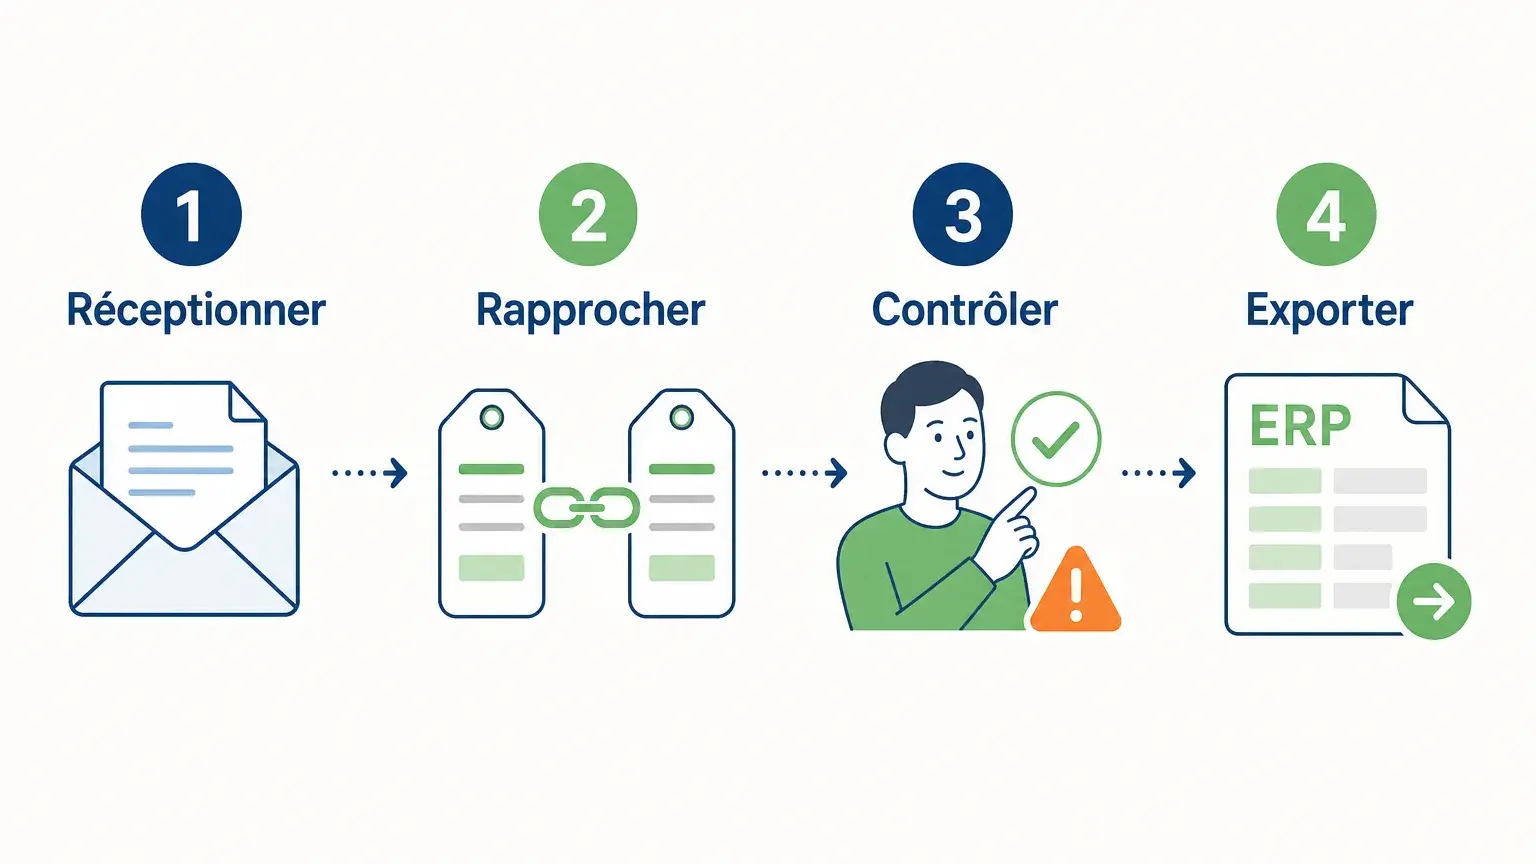
Le déploiement le plus sûr commence par un périmètre limité. Il peut s’agir de quelques clients représentant une part importante du volume, d’un type de document ou d’une famille d’articles. Cette approche permet de mesurer les correspondances réussies, les erreurs de conditionnement et les cas qui doivent rester soumis à validation.
La qualité du référentiel doit être vérifiée avant la mise en production. Les doublons, les articles désactivés encore utilisables, les unités incohérentes ou les fiches incomplètes réduisent la fiabilité de n’importe quel moteur d’IA. L’automatisation ne corrige pas automatiquement une base article désordonnée. Elle risque au contraire de reproduire plus vite une règle incorrecte.
Il faut ensuite définir plusieurs niveaux de confiance. Une référence client déjà validée, associée à un article actif et à une quantité cohérente, peut suivre un parcours rapide. Une désignation ambiguë, un nouveau produit ou une quantité inhabituelle doit être orienté vers un opérateur. Le principe est simple, l’IA traite le flux courant, l’ADV décide lorsque le contexte devient incertain.
En 2026, la diffusion de l’IA dans les entreprises françaises s’accélère, mais les usages restent inégaux. La Banque de France observe début 2026 une utilisation importante de l’IA générative dans les entreprises d’au moins 20 salariés, tout en soulignant que les gains de productivité restent encore limités et variables. Pour un projet ADV, cela renforce l’intérêt d’un indicateur précis et d’un contrôle humain clairement défini.
Enfin, la solution doit s’intégrer aux habitudes existantes. Les clients peuvent continuer à envoyer leurs commandes par e-mail, tandis que les équipes disposent d’une interface pour contrôler, corriger et valider les données. Cette continuité opérationnelle facilite l’adoption, notamment dans les organisations multi-enseignes ou multisites.
Faire des références clients une donnée exploitable
Les références internes utilisées par les clients ne sont pas un détail documentaire. Elles conditionnent la capacité à automatiser une commande de bout en bout. Une approche fiable combine une table de correspondance structurée, l’exploitation de l’historique, l’analyse des désignations, le contrôle des quantités et un rattachement direct à la fiche ERP. Pour les grossistes et distributeurs, la priorité consiste à commencer par un périmètre mesurable, puis à étendre l’automatisation lorsque les données et les règles sont suffisamment maîtrisées.
Questions fréquemment posées
Une référence client peut-elle être différente du code article de l’ERP ?
Oui, c’est fréquent en B2B. Une table de correspondance peut associer le code propre au client à la référence interne, à la désignation, à l’unité de vente et au conditionnement approprié.
Que faire lorsqu’aucune référence n’est indiquée dans la commande ?
Le système peut analyser la désignation en texte libre et rechercher les articles correspondant à la catégorie, aux dimensions, à la matière ou à la norme indiquée. Si plusieurs articles sont possibles, la ligne doit être soumise à validation humaine.
L’apprentissage historique remplace-t-il le contrôle de l’ADV ?
Non. L’historique améliore les propositions de correspondance, mais il ne doit pas transformer une ancienne décision en règle irrévocable. Un contrôle reste nécessaire pour les nouveaux produits, les changements de codification et les quantités inhabituelles.
VistaFlow peut-il traiter des commandes reçues par e-mail ?
Oui, VistaFlow est conçu pour extraire les informations du corps des e-mails et de leurs pièces jointes, notamment les PDF, fichiers Excel et images. Les données peuvent ensuite être contrôlées dans une interface avant leur export vers l’ERP.
Comment mesurer le succès d’une automatisation des références internes ?
Suivez le temps moyen de traitement, le taux de correspondances validées automatiquement, le volume d’exceptions, le taux de correction et le nombre de litiges liés aux références ou aux conditionnements. Ces indicateurs permettent de distinguer un simple gain de transcription d’une amélioration réelle du processus ADV.